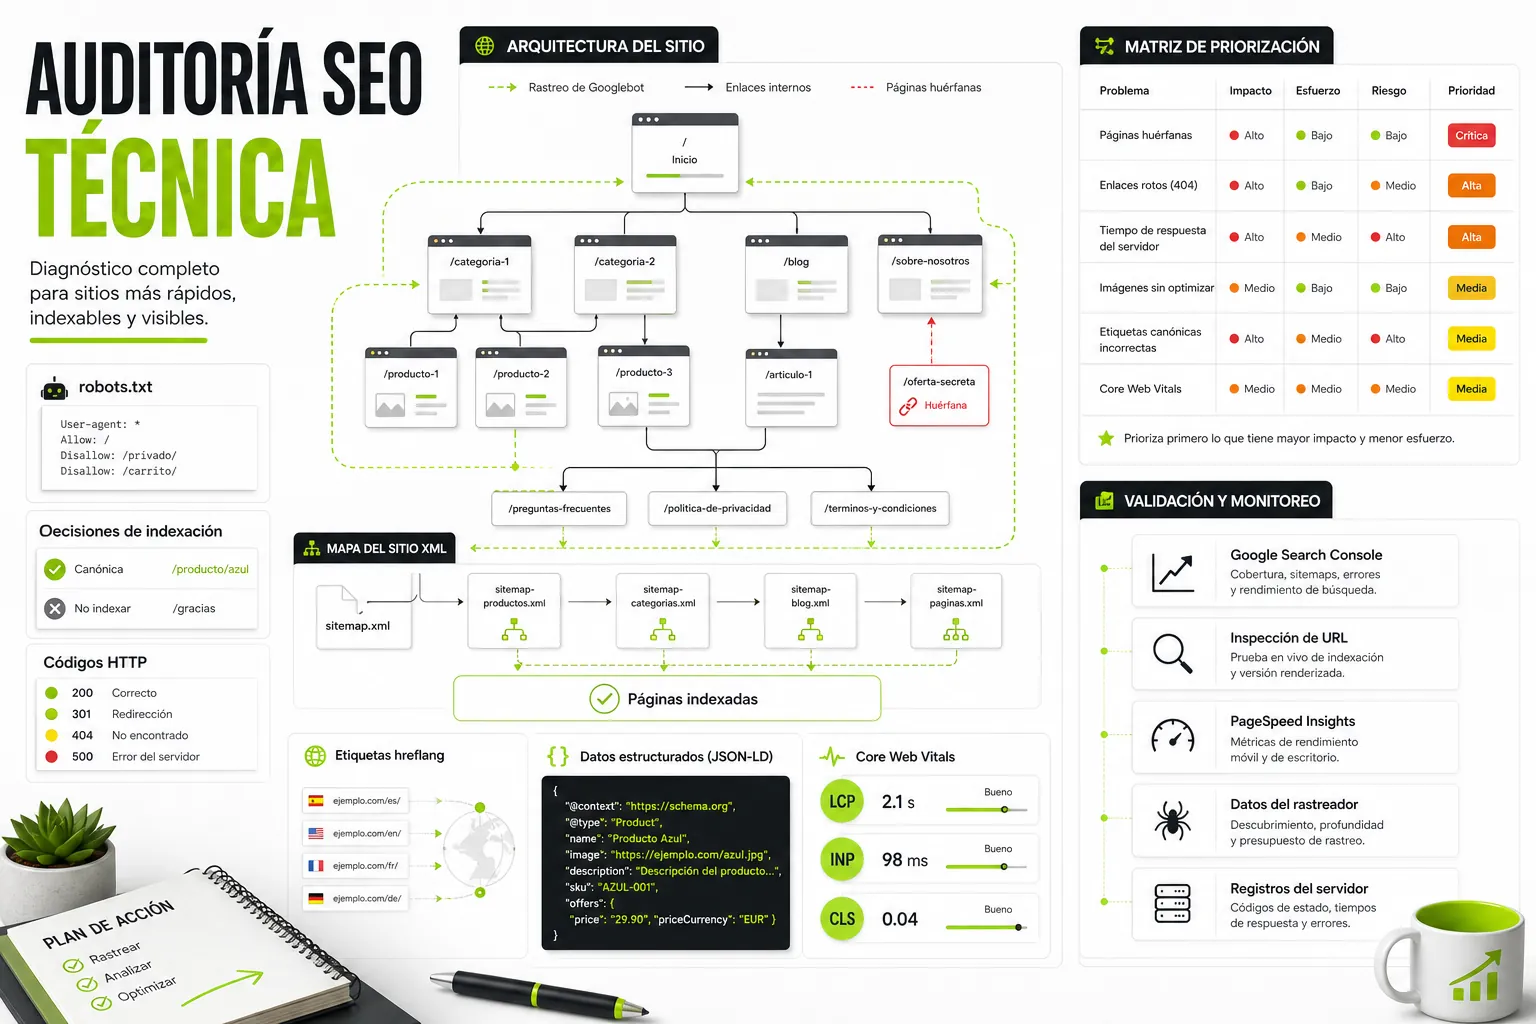
El SEO técnico es la disciplina encargada de optimizar la infraestructura de un sitio web para que los motores de búsqueda puedan rastrear, renderizar e indexar sus páginas sin fricción. Aunque la relevancia del contenido y los enlaces entrantes son factores determinantes para alcanzar las primeras posiciones, ninguno de ellos surte efecto si Googlebot no puede acceder al código fuente, interpretar la estructura de URLs o procesar el renderizado de la interfaz.
Desarrollar una arquitectura técnica sólida garantiza que la autoridad del dominio se distribuya de forma eficiente, que el presupuesto de rastreo no se desperdicie en URLs irrelevantes y que las señales enviadas a Google sean unívocas. Esta guía ofrece una metodología auditable y ejecutable para identificar cuellos de botella técnicos, implementar soluciones basadas en código y priorizar las correcciones según su impacto real en el tráfico orgánico.
Qué es el SEO técnico y por qué es la base del posicionamiento web
El SEO técnico abarca todas las configuraciones a nivel de servidor, arquitectura web, código HTML, directivas de indexación y rendimiento de carga que facilitan el trabajo de las arañas de búsqueda. No se enfoca en la redacción de textos ni en la consecución de menciones externas, sino en la correcta transmisión de datos entre la web y los motores de búsqueda.
Diferencias entre SEO técnico, SEO on-page, contenido y off-page
Para estructurar un plan de trabajo eficaz, es necesario delimitar las responsabilidades de cada área dentro del SEO:
| Pilar SEO | Enfoque principal | Áreas de actuación representativas |
|---|---|---|
| SEO Técnico | Infraestructura, rastreabilidad e indexabilidad | Robots.txt, sitemaps XML, códigos de estado HTTP, canonicals, JavaScript SSR/CSR, Core Web Vitals, Schema.org. |
| SEO On-Page | Optimización sintáctica de elementos en la página | Etiquetas title, meta descriptions, encabezados (h1-h6), atributos alt de imagen, legibilidad. |
| Contenido | Relevancia semántica e intención de búsqueda | Cobertura de entidades, arquitectura temática, alineación con la intención del usuario, frescura editorial. |
| SEO Off-Page | Autoridad de dominio y popularidad externa | Perfil de backlinks, menciones de marca, señales de confianza externa y autoridad contextual. |
El impacto directo de la arquitectura técnica en el rastreo y la indexación
Google utiliza un proceso secuencial de tres fases: descubrimiento (rastreo), procesamiento (renderizado) e indexación. Un fallo en cualquiera de estas etapas interrumpe la cadena de visibilidad:
El proceso sigue esta secuencia: descubrimiento, rastreo por Googlebot, renderizado mediante WRS e indexación en el índice de Google.
Si el archivo robots.txt bloquea los archivos CSS y JavaScript críticos, el servicio de renderizado web (WRS) interpretará una página en blanco o desestructurada, impidiendo que Google identifique los enlaces internos presentes en el DOM. Del mismo modo, si la respuesta del servidor arroja errores 5xx de forma recurrente, Googlebot reducirá la frecuencia de rastreo para no saturar la infraestructura, dejando fuera del índice el contenido recién publicado.
Fundamentos del rastreo: cómo descubren los buscadores tu sitio web
El rastreo es la fase inicial en la que las arañas descubren páginas a través de enlaces explícitos y sitemaps. Administrar este proceso de manera eficiente evita la saturación de los servidores y prioriza las URLs de mayor valor comercial e informativo.
Funcionamiento de Googlebot y gestión del presupuesto de rastreo (crawl budget)
El presupuesto de rastreo (crawl budget) es el número de URLs que Googlebot puede y quiere rastrear en un sitio web durante un periodo determinado. Este límite se calcula en función de dos variables principales:
- Límite de tasa de rastreo (Crawl Health): Determinado por la capacidad de respuesta del servidor. Si el tiempo de respuesta (TTFB) se eleva o el servidor devuelve códigos 503, Google retiene la frecuencia de rastreo.
- Demanda de rastreo (Crawl Demand): Basada en la popularidad de las URLs (PageRank) y la frecuencia de actualización del contenido.
En proyectos pequeños (menos de 10.000 URLs), el presupuesto de rastreo rara vez supone un problema. Sin embargo, en grandes e-commerce o medios de comunicación, el consumo ineficiente en URLs con parámetros, filtros vacíos o redirecciones en cadena impide que las páginas estratégicas se indexen a tiempo.
Optimización del archivo robots.txt y errores frecuentes de configuración
El archivo robots.txt reside en la raíz del dominio (/robots.txt) y define las directivas de acceso para los agentes de usuario. Es la primera instrucción que evalúa Googlebot antes de realizar cualquier petición HTTP.
      # Configuración recomendada para la gestión de recursos y rastreo
User-agent: *
Disallow: /admin/
Disallow: /checkout/
Disallow: /busca/
Disallow: /*?sort=*

# Permitir recursos esenciales para el renderizado
Allow: /wp-includes/js/

# Ubicación del índice de sitemaps
Sitemap: https://ejemplo.com/sitemap_index.xml
Errores habituales en robots.txt:
- Bloquear rutas con
meta robots noindex: Si una página está bloqueada porrobots.txt, Googlebot no leerá la etiqueta HTML<meta name="robots" content="noindex">. La URL podría terminar indexada sin snippet si recibe enlaces externos. - Bloqueo accidental de recursos estáticos: Bloquear
/assets/o carpetas de scripts impide que Google ejecute el renderizado completo en JavaScript. - Uso incorrecto de wildcards (
*): EscribirDisallow: /categoria*bloquea tanto/categoria/como/categoria-de-producto/.
Sitemaps XML: estructura, segmentación y validación de URLs elegibles
Un sitemap XML es un protocolo de declaración de URLs que ayuda a los buscadores a descubrir páginas de manera directa. Para mantener la salud del sitemap, solo deben incluirse URLs canónicas e indexables (código de respuesta 200 OK, sin noindex, sin canonical externo y no bloqueadas en robots.txt).
Para sitios de gran volumen, se debe implementar una arquitectura de índice de sitemaps segmentada por tipología de página o categoría:
      <?xml version="1.0" encoding="UTF-8"?>
<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <sitemap>
    <loc>https://ejemplo.com/sitemaps/sitemap-productos.xml</loc>
    <lastmod>2026-08-01T08:00:00+02:00</lastmod>
  </sitemap>
  <sitemap>
    <loc>https://ejemplo.com/sitemaps/sitemap-blog.xml</loc>
    <lastmod>2026-08-08T10:30:00+02:00</lastmod>
  </sitemap>
</sitemapindex>
Control de indexación y renderizado en sitios modernos
Que una URL sea rastreada no garantiza su inclusión en el índice de Google. Para ello, la página debe superar los controles de calidad, no contener instrucciones de exclusión y ofrecer un DOM procesable.
Diagnóstico con Google Search Console y la herramienta de inspección de URLs
El informe de Páginas en Google Search Console constituye la fuente primaria de datos para diagnosticar exclusiones de índice. Las causas más comunes se dividen en dos categorías:
- Excluidas intencionadamente: “Excluida por la etiqueta ‘noindex’”, “Página con redirección”, “Página duplicada: Google ha elegido una página canónica distinta a la del usuario”.
- Problemas técnicos pendientes de resolución: “Rastreada: actualmente sin indexar” (indica baja calidad percibida o falta de señales de autoridad), “Descubierta: actualmente sin indexar” (problema de presupuesto de rastreo o saturación del servidor).
La Herramienta de inspección de URLs permite comprobar el estado en tiempo real, ver la captura del DOM renderizado por Googlebot y revisar si los recursos JS/CSS se cargaron correctamente durante la prueba.
Renderizado de JavaScript, Server-Side Rendering (SSR) e hidratación
Las aplicaciones web construidas sobre frameworks como React, Angular o Vue presentan desafíos específicos para el SEO técnico debido al modelo de procesamiento:
-
CSR: HTML vacío, descarga de JavaScript, ejecución en el cliente y DOM renderizado; Googlebot debe esperar este proceso.
-
SSR: HTML completo enviado desde el servidor, renderizado inmediato e hidratación de eventos en el cliente.
-
Client-Side Rendering (CSR): El servidor devuelve un archivo HTML prácticamente vacío y la vista se genera en el navegador mediante JavaScript. Si el script falla, se agota el tiempo de ejecución del WRS o el contenido clave depende de eventos del usuario, Googlebot no procesará los textos ni los enlaces.
-
Server-Side Rendering (SSR) y Static Site Generation (SSG): Generan el HTML estructurado en el servidor o durante la fase de compilación. Es la arquitectura idónea para SEO, ya que el rastreador obtiene el contenido y los enlaces en la primera respuesta HTTP.
-
Hidratación: Proceso por el cual la aplicación JS en el cliente toma el HTML estático renderizado por el servidor y le añade los manejadores de eventos. Debe evitarse que la hidratación modifique o elimine nodos del DOM (como etiquetas
canonicalo encabezados) una vez cargado el script.
Matriz de decisión: cuándo usar robots.txt, meta robots noindex o rel=canonical
| Objetivo | Mecanismo a utilizar | Comportamiento de Googlebot | Transferencia de autoridad (PageRank) |
|---|---|---|---|
| Evitar el rastreo por consumo de recursos | robots.txt (Disallow) | No descarga el documento HTML. | No transmite autoridad. |
| Excluir del índice sin bloquear el rastreo | <meta name="robots" content="noindex, follow"> | Rastrea el documento pero lo elimina del índice. | Mantiene el rastreo de enlaces internos salientes. |
| Consolidar URLs duplicadas o similares | <link rel="canonical" href="https://ejemplo.com/pagina-principal" /> | Rastrea ambas URLs pero consolida las señales en la canónica. | Transfiere la mayor parte de la autoridad a la URL canónica. |
| Eliminar definitivamente una página obsoleta | Código de estado HTTP 410 Gone | Elimina la página del índice de forma acelerada. | Cancela la transmisión de autoridad. |
Gestión de contenido duplicado y etiquetas canónicas
Existe contenido duplicado cuando dos o más URLs muestran información idéntica o sustancialmente similar. Esto confunde a los motores de búsqueda a la hora de determinar qué página debe posicionarse para una consulta dada.
Implementación correcta de rel=canonical en URLs con parámetros y variantes
La etiqueta rel="canonical" es una sugerencia fuerte (no una directiva absoluta) que indica a Google cuál es la versión preferida de una página.
Sintaxis en la sección <head> de la URL alternativa (https://ejemplo.com/camisetas?color=rojo):
<link rel="canonical" href="https://ejemplo.com/camisetas" />
Reglas de implementación:
- URLs absolutas: Especificar siempre el protocolo y el dominio completo (
https://ejemplo.com/pagina, nunca/pagina). - Auto-referenciación: Toda página canónica debe contener una etiqueta
rel="canonical"que apunte a sí misma. - Consistencia de protocolo: Las etiquetas canónicas no deben apuntar a variantes
http://ni a URLs con barra final (/) si el sitio utiliza la versión sin barra.
Cómo solucionar problemas de canibalización y URLs duplicadas
La canibalización SEO ocurre cuando múltiples URLs compiten internamente por la misma intención de búsqueda, dividiendo la autoridad del dominio y confundiendo los criterios de relevancia de Google.
La Página A (URL obsoleta) y la Página B (URL nueva) compiten directamente por la misma palabra clave, por lo que ninguna alcanza el Top 3.
Solución técnica estructurada:
- Auditoría de intenciones: Identificar si ambas URLs satisfacen exactamente la misma necesidad de usuario.
- Consolidación via 301: Si la URL antigua no aporta valor diferenciado, aplicar una redirección HTTP 301 desde la versión secundaria hacia la URL principal.
- Fusión de contenidos: Integrar la información valiosa de la URL secundaria en la principal antes de ejecutar la redirección.
- Ajuste de enlazado interno: Actualizar las referencias internas que apuntaban a la URL redirigida para señalar directamente a la URL consolidada.
Códigos de estado HTTP y arquitectura de redirecciones
Los códigos de estado HTTP son las respuestas normalizadas que emite el servidor web ante la petición de un cliente o rastreador. Su correcta gestión es indispensable para la estabilidad del sitio.
Tratamiento de códigos 200, 301, 302, 404, 410 y errores 5xx
- 200 OK: La petición se ha resuelto con éxito y el contenido se entrega correctamente.
- 301 Moved Permanently: Redirección permanente. Transfiere la equidad de enlace (link equity) a la nueva URL y hace que Google reemplace la URL antigua en su índice.
- 302 Found / Temporary Redirect: Redirección temporal. Google mantiene la URL original en el índice y no transfiere la autoridad de forma inmediata.
- 404 Not Found: El recurso no existe. Debe utilizarse para URLs eliminadas sin una alternativa equivalente directa.
- 410 Gone: El recurso ha sido eliminado intencionadamente y no volverá a existir. Googlebot procesa la desindexación de URLs 410 con mayor rapidez que en las 404.
- 500 / 503 Server Error: Errores internos del servidor o indisponibilidad por mantenimiento. Si se prolongan, provocan la pérdida de posiciones y la reducción drástica del rastreo.
Detección y resolución de soft 404, cadenas y bucles de redirección
Un Soft 404 ocurre cuando un servidor devuelve una respuesta HTTP 200 OK para una página que no contiene contenido real (por ejemplo, categorías de e-commerce sin productos o búsquedas internas sin resultados). Google detecta esta discrepancia e interpreta la página como un error 404, bloqueando su posicionamiento.
Cadenas y bucles de redirección:
-
Cadena de redirección: la URL A redirige mediante 301 a la URL B, que a su vez redirige mediante 301 a la URL C. Esto añade latencia y consume presupuesto de rastreo.
-
Bucle de redirección: la URL A redirige mediante 301 a la URL B y esta vuelve a redirigir mediante 301 a la URL A. Es un error crítico de rastreo.
-
Cadenas de redirección: Incrementan el tiempo de latencia (RTT) y consumen presupuesto de rastreo inutilmente. Deben corregirse para que la URL A apunte directamente a la URL C mediante un único salto HTTP 301.
-
Bucles de redirección: Ocurren cuando dos o más URLs se redirigen entre sí cíclicamente. Esto provoca que la araña cancele la petición arrojando un error de navegación.
Arquitectura de la información y estructura de enlazado interno
La arquitectura de la información define la manera en que se organiza y jerarquiza el contenido de un sitio web. El enlazado interno representa el mecanismo técnico mediante el cual la autoridad del dominio y el PageRank fluyen entre las distintas secciones.
Jerarquía web, profundidad de clic y distribución del Juice SEO
Una arquitectura web eficiente debe limitar la profundidad de clic (click depth): el número de pasos necesarios para llegar a cualquier página desde la portada (homepage).
La jerarquía recomendada parte de la página de inicio, con profundidad 0, seguida de una categoría en profundidad 1, una subcategoría en profundidad 2 y un producto o artículo en profundidad 3.
Mantener las páginas estratégicas a una profundidad no superior a 3 clics asegura que reciban una fracción suficiente del PageRank distribuido desde la página de inicio. Para profundizar en la construcción de relaciones semánticas entre entidades y agrupaciones de contenido, conviene revisar la guía de SEO semántico , que complementa este pilar técnico enfocándose en el modelado conceptual del conocimiento.
Identificación y recuperación de páginas huérfanas mediante migas de pan y enlaces HTML
Una página huérfana es aquella que no recibe ningún enlace interno desde ninguna otra URL indexable del propio sitio. Aunque figure en el sitemap XML, resulta de difícil acceso para Googlebot y carece de transferencia de autoridad interna.
Estrategia de prevención e integración:
- Migas de pan (Breadcrumbs) en HTML: Implementar una estructura jerárquica explícita en el DOM que conecte la página actual con sus niveles superiores.
- Enlaces contextuales en código HTML: Los enlaces deben utilizar etiquetas relacionales
<a href="...">estándar en el servidor. Los enlaces basados en eventos JS (<div onclick="location.href='...'">) no son interpretados de forma consistente como rutas de rastreo por Googlebot.
Rendimiento web y Core Web Vitals: LCP, INP y CLS
Los Core Web Vitals (CWV) son métricas cuantitativas definidas por Google para evaluar la experiencia de usuario en términos de velocidad de carga, interactividad y estabilidad visual. Son un factor explícito de ordenación en los resultados de búsqueda.
| Métrica | Aspecto evaluado | Umbral recomendado |
|---|---|---|
| LCP | Renderizado útil | Menos de 2,5 s |
| INP | Interactividad | Menos de 200 ms |
| CLS | Estabilidad visual | Menos de 0,1 |
Medición real con datos de campo (CrUX) frente a datos de laboratorio (Lighthouse)
- Datos de campo (Chrome User Experience Report - CrUX): Reflejan las experiencias reales de usuarios anónimos midiendo el percentil 75 durante los últimos 28 días. Son las métricas que Google utiliza de forma oficial para evaluar los Core Web Vitals de una URL o dominio.
- Datos de laboratorio (Lighthouse / PageSpeed Insights Synthetic): Recogidos en un entorno controlado con emulación de dispositivos y redes estándar. Son útiles para depurar problemas durante la fase de desarrollo, pero no determinan las evaluaciones de posicionamiento.
Claves de optimización para imágenes, caché, compresión y ejecución de JavaScript
-
Largest Contentful Paint (LCP): Mide el tiempo necesario para renderizar el elemento visual más grande en la pantalla (habitualmente una imagen de portada o un bloque de texto H1).
- Servir imágenes en formatos de nueva generación (WebP o AVIF).
- Aplicar la propiedad
fetchpriority="high"al elemento de imagen LCP y evitar el atributoloading="lazy"en ese recurso concreto. - Utilizar redes de distribución de contenido (CDN) para reducir la latencia Time to First Byte (TTFB).
-
Interaction to Next Paint (INP): Evalúa la respuesta general de la página ante las interacciones del usuario (clics, toques en pantalla, entradas de teclado) midiendo la latencia de todos los eventos procesados.
- Dividir las tareas largas de JavaScript (Long Tasks > 50ms) utilizando
requestAnimationFrameosetTimeout. - Reducir el tamaño de los scripts de terceros e diferir la ejecución del JS no crítico mediante las propiedades
deferoasync.
- Dividir las tareas largas de JavaScript (Long Tasks > 50ms) utilizando
-
Cumulative Layout Shift (CLS): Mide la frecuencia y magnitud de los cambios de diseño e interfaz inesperados durante la carga.
- Especificar siempre las dimensiones
widthyheighten las etiquetas de imagen y de vídeo. - Reservar espacio estático mediante CSS para contenedores de anuncios o banners dinámicos.
- Utilizar
font-display: swappara gestionar la carga de fuentes web sin causar destellos de texto no estilizado (FOUT).
- Especificar siempre las dimensiones
Datos estructurados y Schema.org para enriquecer el renderizado
Los datos estructurados utilizan un vocabulario estandarizado (Schema.org) redactado en formato JSON-LD que proporciona contexto directo sobre el significado de una página a los motores de búsqueda.
Implementación de JSON-LD para artículos, productos, migas de pan y ofertas
El marcado debe insertarse preferentemente dentro de una etiqueta <script type="application/ld+json"> en el HTML de la página.
Ejemplo de JSON-LD para un producto con ofertas y migas de pan:
      {
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "BreadcrumbList",
      "itemListElement": [
        {
          "@type": "ListItem",
          "position": 1,
          "name": "Inicio",
          "item": "https://ejemplo.com/"
        },
        {
          "@type": "ListItem",
          "position": 2,
          "name": "Hardware",
          "item": "https://ejemplo.com/hardware"
        }
      ]
    },
    {
      "@type": "Product",
      "name": "Servidor NAS 4-Bay",
      "image": "https://ejemplo.com/img/nas.jpg",
      "description": "Unidad de almacenamiento en red para copias de seguridad de alta velocidad.",
      "sku": "NAS-004",
      "offers": {
        "@type": "Offer",
        "price": "399.00",
        "priceCurrency": "EUR",
        "availability": "https://schema.org/InStock",
        "url": "https://ejemplo.com/hardware/nas-4-bay"
      }
    }
  ]
}
Validación técnica e implicaciones en los resultados enriquecidos de Google
La correcta sintaxis de un marcado Schema no garantiza la consecución de fragmentos enriquecidos (rich snippets). Para que Google los muestre en la SERP, deben cumplirse tres condiciones:
- Elegibilidad técnica: El código debe ser válido según la prueba de resultados enriquecidos (Rich Results Test).
- Representatividad real: Los datos declarados en el JSON-LD deben coincidir exactamente con la información visible para el usuario en el DOM HTML.
- Criterio de calidad del sitio: El dominio debe contar con la confianza y relevancia suficientes a ojos del algoritmo de Google.
SEO técnico avanzado para ecommerce, sitios grandes e internacionalización
Las plataformas con catálogos extensos o múltiples idiomas requieren arquitecturas específicas para controlar el consumo de recursos de rastreo y evitar la duplicidad masiva.
Manejo de navegación facetada, parámetros de filtrado y paginación
La navegación facetada en e-commerce (filtros por color, talla, precio o marca) genera un volumen exponencial de URLs con parámetros que pueden colapsar el presupuesto de rastreo.
      URL Base:     /camisas-hombre (Indexable)
Parámetro 1:  /camisas-hombre?color=azul (Posible duplicado / Controlar)
Parámetro 2:  /camisas-hombre?color=azul&talla=xl&precio=50-100 (URL vacía de valor SEO)
Estrategias de gestión técnica:
- Canonicalización estricta: Orientar los filtros no estratégicos hacia la categoría base mediante
rel="canonical". - Desindexación activa: Aplicar
<meta name="robots" content="noindex">en combinaciones de filtros de baja demanda de búsqueda. - Atributo rel=“next” / rel=“prev”: Aunque Google dejó de utilizar estas etiquetas como señal de consolidación de paginación, se debe mantener una estructura de URLs paginadas limpias (
/categoria?p=2), con etiquetas canónicas auto-referenciadas y enlaces<a href="...">indexables.
Para profundizar en la implementación concreta de plataformas como Shopify, Magento o WooCommerce, consulta la guía especializada en SEO para ecommerce , donde se analizan las directivas avanzadas de catálogo.
Configuración de etiquetas hreflang para sitios multiidioma y multirregión
Las etiquetas hreflang permiten a los motores de búsqueda servir la versión lingüística o regional adecuada de una página según la ubicación e idioma del usuario.
Sintaxis recomendada en la sección <head> de la URL española (https://ejemplo.com/es/pagina):
      <link rel="alternate" hreflang="es-ES" href="https://ejemplo.com/es/pagina" />
<link rel="alternate" hreflang="en-US" href="https://ejemplo.com/en/pagina" />
<link rel="alternate" hreflang="x-default" href="https://ejemplo.com/pagina" />
Reglas de validación en la implementación de hreflang:
- Reciprocidad obligatoria: Si la versión
/es/enlaza a la versión/en/, la versión/en/debe contener un enlace de retorno idéntico hacia la versión/es/. Si falta la correspondencia mutua, la etiqueta queda invalidadas. - Valor
x-default: Define la página de destino por defecto para usuarios cuya configuración de idioma o región no coincida con ninguno de los códigos especificados.
Migraciones web, HTTPS y protocolos de seguridad
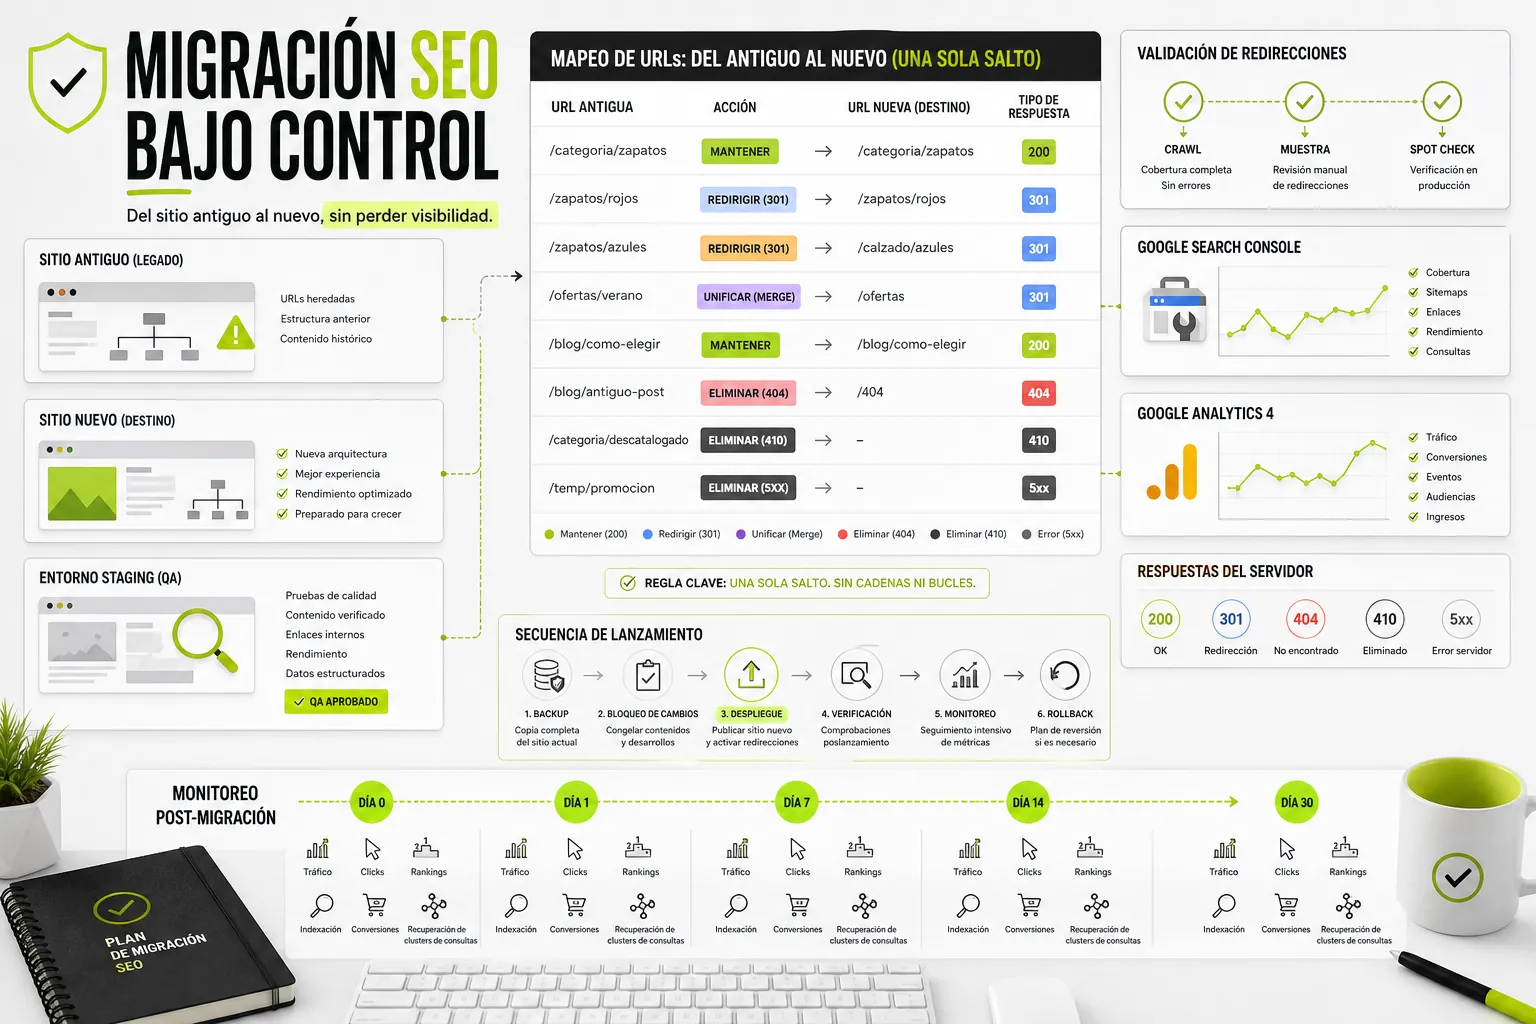
Una migración web involucra cambios sustanciales en la estructura de URLs, el dominio, el CMS o la infraestructura del servidor. Un error en el proceso puede provocar caídas severas y prolongadas de tráfico orgánico.
Lista de comprobación previa y posterior al lanzamiento de una migración
Fase de pre-lanzamiento
- Mapeo de URLs de origen a destino en una tabla 1:1.
- Extracción de métricas base en Search Console y Analytics.
- Verificación de reglas de redirección 301 en Staging.
Fase de post-lanzamiento
- Eliminación del bloqueo de rastreo mediante noindex o robots.txt.
- Envío del nuevo sitemap XML en Search Console.
- Ejecución de la herramienta de Cambio de Dirección de GSC.
- Auditoría de rastreo sobre respuestas 301, 404 y 5xx.
Entornos de staging, gestión de certificados SSL y planes de rollback
- Aislamiento del entorno de pruebas (Staging): Proteger la web en desarrollo mediante autenticación HTTP básica (Basic Auth) o restricción de acceso por dirección IP. Confiar únicamente en un archivo
robots.txtpara bloquear el entorno de desarrollo es un riesgo elevado, ya que las URLs pueden llegar a indexarse mediante enlaces externos. - Configuración de certificados SSL/TLS: Asegurar la migración hacia protocolo HTTPS utilizando certificados válidos y redirigiendo todo el tráfico HTTP mediante reglas 301 en la configuración del servidor web (Nginx / Apache).
- Plan de marcha atrás (Rollback): Mantener un snapshot o copia de respaldo íntegra del sistema antiguo en el servidor durante un periodo mínimo de 30 días para revertir los cambios en caso de un fallo técnico catastrófico en la resolución de URLs.
Metodología de auditoría SEO técnica y matriz de priorización
Una auditoría técnica eficiente requiere combinar datos de múltiples fuentes para diagnosticar la salud técnica del proyecto sin perderse en métricas superfluas.
Flujo de trabajo con Google Search Console, rastreadores y análisis de logs
- Rastreo completo mediante crawler técnico: Ejecutar herramientas como Screaming Frog o Sitebulb para mapear la arquitectura completa del código, extraer etiquetas canónicas, códigos de respuesta y tiempos de carga.
- Cruce de datos con Google Search Console: Exportar los informes de indexación y rendimiento para contrastar las URLs que la araña local puede rastrear frente a la visión real de Googlebot.
- Análisis de archivos de registros del servidor (Log Analysis): Analizar los archivos
access.logpara evaluar el comportamiento real de las IP de Googlebot. Permite identificar la frecuencia de rastreo por sección, el consumo ineficiente de recursos y las URLs en las que el robot se detiene sin procesar el contenido.
Cuando se trabaja con volúmenes masivos de datos o cientos de dominios, las revisiones manuales en la interfaz web de Search Console se convierten en un cuello de botella. En estos escenarios, el uso de la Google Search Console API permite automatizar la inspección de URLs, extraer información de indexación a gran escala y monitorizar el estado de los sitemaps mediante scripts de integración continua.
Priorización por impacto, esfuerzo y riesgo técnico
No todos los fallos detectados en una auditoría requieren una intervención inmediata. La matriz de priorización evalúa cada tarea según tres dimensiones técnicas:
| Severidad | Tipo de problema técnico | Impacto en tráfico | Esfuerzo de desarrollo | Riesgo | Acción recomendada |
|---|---|---|---|---|---|
| Crítica | Directiva noindex global enviada a producción accidentalmente. | Muy Alto | Bajo | Alto | Corregir de forma inmediata (< 2 horas). |
| Alta | Redirecciones en cadena o bucles en secciones estratégicas. | Alto | Medio | Medio | Programar en el sprint técnico actual. |
| Media | Faltan marcas de Schema.org en páginas secundarias o migas de pan. | Medio | Bajo | Bajo | Planificar en la hoja de ruta trimestral. |
| Baja | Atributos alt ausentes en imágenes secundarias del blog. | Bajo | Bajo | Bajo | Corregir en mantenimiento rutinario. |
Conexión del diagnóstico técnico con acciones de contenido en Dango
Resolver los cuellos de botella técnicos garantiza que el sitio web sea plenamente indexable y eficiente. Sin embargo, para traducir esa infraestructura optimizada en incrementos sostenibles de tráfico orgánico, es necesario conectar los datos técnicos de indexación con la optimización editorial.
Una vez que la arquitectura, el presupuesto de rastreo y los códigos de estado se han estabilizado, las métricas de rendimiento extraídas de Google Search Console sirven para identificar qué páginas indexadas presentan problemas de posicionamiento, palabras clave en distancia de posicionamiento o canibalizaciones de contenido. En esta fase, aplicar un flujo de trabajo estructurado de estrategia de contenidos SEO ayuda a canalizar la autoridad técnica recuperada hacia briefs optimizados, clusters temáticos y enlazado interno estratégico.
Dango es una plataforma de SEO basada en suscripción que se conecta con Google Search Console y los sitemaps XML de tu sitio para organizar clústeres de palabras clave, generar briefs estructurados y articular estrategias de enlazado interno. Con planes desde 99 USD al mes (plan Starter) y299/mes (plan Professional), Dango ayuda a equipos y profesionales SEO a convertir el diagnóstico de Search Console en un plan de acción de contenido ejecutable. Si deseas transformar las señales de tu web en decisiones editoriales priorizadas, visita dango.sh/es y pulsa en Empieza ya para conocer sus planes.
Preguntas frecuentes sobre SEO técnico
¿Cuál es la diferencia entre el archivo robots.txt y la etiqueta meta robots noindex?
El archivo robots.txt impide que los motores de búsqueda rastreen y descarguen el contenido de una URL, gestionando así el consumo del presupuesto de rastreo. Por el contrario, la etiqueta <meta name="robots" content="noindex"> permite el rastreo de la página pero le indica a Google que debe eliminarla (o no incluirla) en el índice de búsqueda. Si una URL está bloqueada en el robots.txt, Google no podrá leer la etiqueta noindex y la página podría terminar indexada sin snippet si recibe enlaces externos.
¿Por qué la métrica INP sustituyó a FID en los Core Web Vitals de Google?
Interaction to Next Paint (INP) sustituyó oficialmente a First Input Delay (FID) porque proporciona una evaluación mucho más precisa y holística de la interactividad. Mientras que FID solo medía el retardo de la primera interacción del usuario al cargar la página, INP evalúa la latencia de todas las interacciones físicas (clics, toques y entradas de teclado) ocurridas a lo largo de toda la sesión del usuario, registrando la peor respuesta observada.
¿Cómo afectan las redirecciones 302 al traspaso de autoridad SEO frente a las 301?
Una redirección 301 indica un cambio permanente, transfiriendo la equidad de enlace (link equity) y provocando que Google reemplace la URL antigua por la nueva en su índice. Una redirección 302 señala un cambio temporal, por lo que Google conserva la URL de origen indexada y no transfiere la autoridad de forma inmediata. Sin embargo, si Google detecta que una redirección 302 se mantiene indefinidamente en el tiempo, terminará tratándola internamente como una redirección 301.
¿Los datos estructurados garantizan la aparición de fragmentos enriquecidos en Google?
No. La implementación correcta de datos estructurados en formato JSON-LD es un requisito técnico que otorga elegibilidad para los resultados enriquecidos (rich snippets), pero no garantiza su publicación. La decisión final depende de los algoritmos de Google, que evalúan la calidad del sitio, la relevancia de la consulta, la autoridad del dominio y la fidelidad de los datos marcados con respecto al contenido visible para el usuario.
¿Cuándo es necesario realizar un análisis de logs en una auditoría de SEO técnico?
El análisis de logs del servidor se vuelve imprescindible en sitios web de gran volumen (e-commerce con miles de productos, medios de comunicación o plataformas clasificadas) donde se observan problemas de indexación lenta, discrepancias entre el contenido publicado y el rastreado, o caídas inexplicables en la frecuencia de visita de Googlebot. En proyectos pequeños o medianos, los informes de Google Search Console suelen ser suficientes para el diagnóstico estándar.
¿Cómo se debe gestionar el SEO técnico en sitios web con navegación facetada?
Para evitar la creación masiva de URLs duplicadas y el agotamiento del presupuesto de rastreo por combinaciones infinitas de filtros, se deben definir reglas claras: canonicalizar los filtros secundarios hacia la categoría raíz, aplicar directivas noindex o bloquear vía robots.txt las combinaciones de filtros sin demanda de búsqueda, y permitir la indexación únicamente en aquellos filtros con volumen de búsqueda e intención comprobada (por ejemplo, categorías consolidadas de marca o tipo de producto).