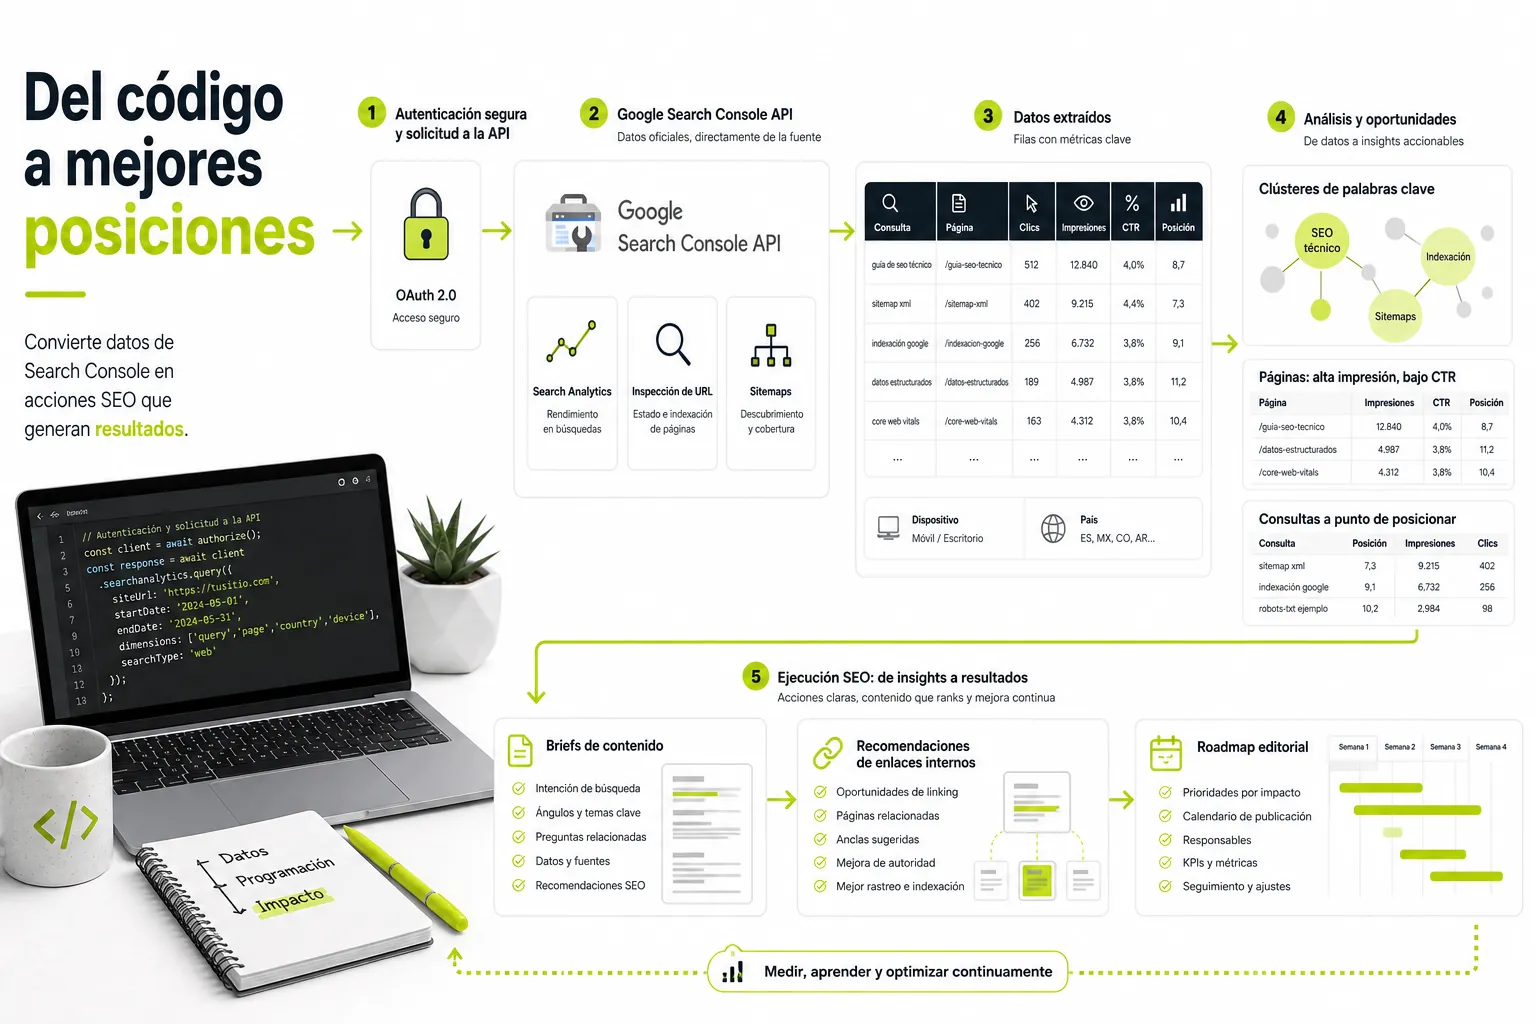
El análisis de rendimiento orgánico en sitios web con miles o millones de URLs se enfrenta rápidamente a las limitaciones de las herramientas visuales tradicionales. Aunque la plataforma web de Google Search Console ofrece una visión clara del rendimiento de búsqueda, la google search console api es la vía imprescindible para superar las fronteras de exportación manual, automatizar flujos de auditoría y alimentar sistemas de inteligencia de datos con métricas precisas de impresiones, clics, CTR y posiciones.
Esta guía aborda la implementación técnica de la API de Search Console desde la autenticación hasta la ejecución de estrategias SEO avanzadas. A través de ejemplos de código en Python, JavaScript y cURL, esquemas de peticiones JSON y flujos de automatización, aprenderás a extraer volúmenes masivos de datos para transformar simples métricas en decisiones editoriales y de optimización técnica.
¿Qué es la Google Search Console API y cuándo utilizarla?
La google search console api es una interfaz de programación de aplicaciones RESTful proporcionada por Google que permite acceder de manera programática a los datos de rendimiento en el buscador, estado de indexación, estructura de sitemaps y gestión de propiedades verificadas.
A diferencia de la consola gráfica, diseñada para la consulta puntual y el diagnóstico manual, la API actúa como una tubería directa de datos que puede integrarse en bases de datos internas, cuadros de mando corporativos (en herramientas como Looker Studio o Power BI) o algoritmos propios de priorización de contenidos.
Diferencias entre la interfaz web, exportaciones CSV y la extracción programática
El ecosistema de Search Console ofrece tres formas de acceder a la información, cada una orientada a distintos volúmenes y niveles de madurez técnica:
| Característica | Interfaz Web de GSC | Exportación CSV / Sheet | Google Search Console API |
|---|---|---|---|
| Límite de filas por consulta | 1.000 filas visibles | 1.000 filas por archivo | Hasta 25.000 filas por petición (paginable sin límite global) |
| Histórico accesible | 16 meses | 16 meses | 16 meses (extensible si se almacena en base de datos propia) |
| Frecuencia de actualización | Manual | Manual | Automatizable (scripts programados, tareas CRON) |
| Combinación de dimensiones | Limitada (generalmente 2) | Limitada a la vista exportada | Multidimensional (Consulta, Página, País, Dispositivo, Fecha) |
| Automatización | Nula | Nula | Completa (integración en canalizaciones ETL/ELT) |
El uso de la API resulta imprescindible cuando se requiere monitorear sitios de gran escala (e-commerce, medios de comunicación, marketplaces), cruzando miles de palabras clave con sus URLs de destino sin sufrir el recorte de datos (data clipping) que impone la interfaz gráfica.
Recursos principales: Search Analytics, URL Inspection, Sites y Sitemaps
La API está estructurada en distintos recursos y endpoints orientados a tareas específicas dentro del mantenimiento y análisis SEO:
- Search Analytics Resource (
searchanalytics): Es el motor principal de extracción. Permite consultar impresiones, clics, porcentaje de clics (CTR) y posición media combinando dimensiones como consulta (query), página (page), país (country), dispositivo (device), tipo de búsqueda y fecha (date). - URL Inspection API (
urlInspection.index:inspect): Permite verificar de forma programática el estado de indexación de una URL concreta, revelando la canónica seleccionada por Google, el estado del rastreo, la disponibilidad de indexación y los posibles bloqueos técnicos. - Sites Resource (
sites): Permite listar las propiedades verificadas dentro de la cuenta del usuario, agregar nuevas propiedades o gestionar los niveles de acceso y permisos. - Sitemaps Resource (
sitemaps): Facilita la consulta, envío, validación y eliminación de archivos sitemap XML asociados a una propiedad sin necesidad de interactuar con el panel de administración.
Configuración del proyecto en Google Cloud y autenticación OAuth 2.0
Para realizar peticiones a la API, es necesario configurar un entorno seguro en Google Cloud Platform (GCP) que gestione las credenciales y garantice que las peticiones estén autorizadas.
Creación de credenciales, Service Accounts y selección de OAuth Scopes
El proceso de habilitación requiere los siguientes pasos dentro de la consola de Google Cloud:
- Creación de un Proyecto: Accede a Google Cloud Console y crea un proyecto dedicado (por ejemplo,
seo-gsc-automation). - Habilitación de la API: En la biblioteca de APIs, busca “Google Search Console API” (o Search Console API) y haz clic en Habilitar.
- Elección del método de autenticación:
- OAuth 2.0 Client ID: Ideal para aplicaciones de escritorio o web donde un usuario humano autoriza el acceso a sus propiedades mediante una pantalla de inicio de sesión.
- Service Account (Cuenta de Servicio): Ideal para scripts de servidor, tareas automatizadas y pipelines de datos donde no hay interacción humana. Genera un archivo de clave privada en formato JSON.
Selección de Scopes (Alcances de Autorización)
Para interaccionar con los datos, debes solicitar los permisos adecuados durante la autenticación:
- Lectura y Escritura:
https://www.googleapis.com/auth/webmasters(Permite consultar rendimiento, enviar sitemaps y modificar propiedades). - Solo Lectura:
https://www.googleapis.com/auth/webmasters.readonly(Recomendado para scripts de análisis y extracción de datos que no necesiten modificar configuraciones).
Verificación de propiedad y formato correcto del parámetro siteUrl
Un error técnico frecuente al trabajar con la API es formatear incorrectamente el parámetro siteUrl. Este identificador debe coincidir exactamente con el tipo de propiedad configurado en Search Console.
Existen dos estructuras de propiedad:
- Propiedades de Prefijo de URL: Requieren el protocolo exacto y la barra diagonal final si corresponde.
- Ejemplo:
https://www.ejemplo.com/ohttp://subdominio.ejemplo.com/
- Ejemplo:
- Propiedades de Dominio (Domain Properties): Incluyen todo el tráfico de todos los subdominios y protocolos. Deben llevar el prefijo
sc-domain:.- Ejemplo:
sc-domain:ejemplo.com
- Ejemplo:
Si utilizas una Cuenta de Servicio, debes copiar la dirección de correo electrónico generada (por ejemplo, gsc-exporter@proyecto.iam.gserviceaccount.com) y añadirla como usuario con permisos de Propietario o Usuario completo dentro de la configuración de usuarios de la propiedad de Google Search Console.
Estructura de consultas en la Search Analytics API
El endpoint de Search Analytics (https://www.googleapis.com/webmasters/v3/sites/{siteUrl}/searchAnalytics/query) procesa peticiones HTTP POST con un cuerpo estructurado en JSON que define los criterios de filtrado y agregación.
Parámetros clave de petición: dimensiones, rangos de fechas y filtros
Los parámetros del cuerpo de la petición definen el alcance de la extracción:
-
startDateyendDate: Fechas en formatoYYYY-MM-DD. El rango no puede ser superior a 16 meses atrás desde la fecha actual. -
dimensions: Array de cadenas que define cómo se agruparán los datos. Valores permitidos:"date","query","page","country","device","searchAppearance". -
dimensionFilterGroups: Permite aplicar filtros lógicos (contains,equals,notContains,notEquals) sobre dimensiones específicas. -
type: Tipo de búsqueda a consultar. Los valores aceptados son"web"(por defecto),"image","video","news","discover"y"googleNews".
      {
  "startDate": "2026-07-01",
  "endDate": "2026-07-31",
  "dimensions": ["query", "page"],
  "dimensionFilterGroups": [
    {
      "filters": [
        {
          "dimension": "country",
          "operator": "equals",
          "expression": "esp"
        }
      ]
    }
  ],
  "rowLimit": 5000,
  "startRow": 0
}
Métricas fundamentales: clics, impresiones, CTR y posición media
Cada combinación de dimensiones devuelta por la API proporciona cuatro métricas básicas:
-
clicks: Número de veces que un usuario hizo clic en un resultado de búsqueda que llevó a la propiedad. -
impressions: Número de veces que una URL de la propiedad apareció en los resultados de búsqueda para un usuario. -
ctr: Porcentaje de clics calculado como(clicks / impressions). Es un valor flotante entre0.0y1.0. -
position: Posición media del resultado más alto de la propiedad para la consulta especificada. Si una página aparece en la posición 3 y 7, la posición registrada será 3.
Manejo de paginación, límite de filas (rowLimit) y tipos de agregación
El parámetro rowLimit establece la cantidad máxima de resultados por respuesta HTTP, con un límite superior estricto de 25.000 filas por petición. Para extraer conjuntos de datos mayores, es necesario implementar un bucle de paginación incrementando el parámetro startRow.
Modos de Agregación (aggregationType)
-
auto: Google selecciona automáticamente el modo de agregación según las dimensiones solicitadas. -
byPage: Agrupa las métricas calculando impresiones y clics a nivel de URL individual. Es el modo recomendado cuando la dimensión"page"está presente. -
byProperty: Agrupa las métricas a nivel de dominio completo. Si dos URLs de la misma propiedad aparecen para una sola búsqueda, se contabiliza como una única impresión global de la propiedad.
Ejemplos prácticos de código y respuestas JSON (Python, JavaScript y cURL)
A continuación se detallan implementaciones listas para producción en distintos lenguajes para interactuar con la google search console api.
Petición REST y estructura del JSON de respuesta paso a paso
Una respuesta exitosa de la API devuelve una estructura JSON que contiene el array rows. Cada elemento de este array incluye la clave keys (cuyos valores coinciden con las dimensiones solicitadas en el mismo orden) y las métricas numéricas asociadas.
JSON de Respuesta de Ejemplo:
      {
  "rows": [
    {
      "keys": [
        "google search console api",
        "https://dango.sh/blog/es/google-search-console-api"
      ],
      "clicks": 145,
      "impressions": 2300,
      "ctr": 0.06304347826086957,
      "position": 4.2
    },
    {
      "keys": [
        "exportar datos search console python",
        "https://dango.sh/blog/es/google-search-console-api"
      ],
      "clicks": 82,
      "impressions": 1100,
      "ctr": 0.07454545454545454,
      "position": 2.8
    }
  ],
  "responseAggregationType": "byPage"
}
Script de automatización en Python con la librería google-api-python-client
Para ejecutar este script, instala previamente la librería oficial de Google: pip install google-api-python-client google-auth.
      import pandas as pd
from google.oauth2 import service_account
from googleapiclient.discovery import build

# Configuración de constantes
KEY_FILE_PATH = 'credentials.json'
SCOPES = ['https://www.googleapis.com/auth/webmasters.readonly']
SITE_URL = 'sc-domain:ejemplo.com'

def fetch_gsc_data(site_url, start_date, end_date):
    # Cargar credenciales de la Cuenta de Servicio
    credentials = service_account.Credentials.from_service_account_file(
        KEY_FILE_PATH, scopes=SCOPES
    )

    # Construir el servicio de la API (v3 / searchconsole)
    service = build('searchconsole', 'v1', credentials=credentials)

    all_rows = []
    start_row = 0
    row_limit = 25000

    while True:
        request_body = {
            'startDate': start_date,
            'endDate': end_date,
            'dimensions': ['query', 'page'],
            'rowLimit': row_limit,
            'startRow': start_row,
            'aggregationType': 'byPage'
        }

        # Ejecutar la petición
        response = service.searchanalytics().query(
            siteUrl=site_url, body=request_body
        ).execute()

        rows = response.get('rows', [])
        if not rows:
            break

        for row in rows:
            all_rows.append({
                'query': row['keys'][0],
                'page': row['keys'][1],
                'clicks': row['clicks'],
                'impressions': row['impressions'],
                'ctr': row['ctr'],
                'position': row['position']
            })

        start_row += row_limit
        print(f"Extraídas {len(all_rows)} filas hasta el momento...")

    # Convertir a DataFrame de Pandas para análisis SEO
    df = pd.DataFrame(all_rows)
    return df

if __name__ == '__main__':
    df_seo = fetch_gsc_data(SITE_URL, '2026-07-01', '2026-07-31')
    df_seo.to_csv('gsc_rendimiento.csv', index=False, encoding='utf-8')
    print("Extracción completada y guardada en gsc_rendimiento.csv")
Extracción rápida con cURL y Node.js
Extracción mediante cURL (Requiere OAuth Access Token):
      curl -X POST \
  'https://www.googleapis.com/webmasters/v3/sites/sc-domain%3Aejemplo.com/searchAnalytics/query' \
  -H 'Authorization: Bearer YOUR_ACCESS_TOKEN' \
  -H 'Content-Type: application/json' \
  -d '{
    "startDate": "2026-07-01",
    "endDate": "2026-07-07",
    "dimensions": ["query"],
    "rowLimit": 10
  }'
Extracción en Node.js (usando @googleapis/searchconsole):
      const { google } = require('googleapis');
const key = require('./credentials.json');

const auth = new google.auth.JWT(
  key.client_email,
  null,
  key.private_key,
  ['https://www.googleapis.com/auth/webmasters.readonly']
);

const searchconsole = google.searchconsole({ version: 'v1', auth });

async function runExtraction() {
  try {
    const res = await searchconsole.searchanalytics.query({
      siteUrl: 'sc-domain:ejemplo.com',
      requestBody: {
        startDate: '2026-07-01',
        endDate: '2026-07-15',
        dimensions: ['query', 'page'],
        rowLimit: 100
      },
    });

    console.log('Resultados obtenidos:', res.data.rows);
  } catch (error) {
    console.error('Error al consultar la API de GSC:', error.message);
  }
}

runExtraction();
Gestión programática de Sitemaps y estado de indexación
Además de extraer datos de rendimiento, la API proporciona capacidades críticas para la auditoría de SEO técnico e indexación.
Consulta de estado de URLs mediante la URL Inspection API
La URL Inspection API permite auditar el estado de rastreo e indexación de direcciones específicas en tiempo real.
Petición HTTP de inspección:
      POST https://searchconsole.googleapis.com/v1/urlInspection/index:inspect
{
  "inspectionUrl": "https://www.ejemplo.com/pagina-ejemplo",
  "siteUrl": "sc-domain:ejemplo.com"
}
La respuesta incluye detalles diagnósticos fundamentales:
-
coverageState: Indica si la URL está indexada (INDEXED), excluida por etiqueta noindex (EXCLUDED_BY_NOINDEX), o presenta errores. -
userCanonical: La URL canónica declarada explícitamente en el código HTML de la página. -
googleCanonical: La URL canónica que el algoritmo de Google ha seleccionado tras evaluar la página. Si no coincide conuserCanonical, existe un conflicto canónico explícito. -
lastCrawlTime: Marca de tiempo del último rastreo realizado por el Googlebot.
Listado, envío y eliminación de sitemaps desde código
El recurso sitemaps permite gestionar el ciclo de vida de los índices de URLs directamente desde los sistemas de gestión de contenidos (CMS):
- Listar sitemaps:
GET https://www.googleapis.com/webmasters/v3/sites/{siteUrl}/sitemaps - Enviar sitemap:
PUT https://www.googleapis.com/webmasters/v3/sites/{siteUrl}/sitemaps/{feedpath} - Eliminar sitemap:
DELETE https://www.googleapis.com/webmasters/v3/sites/{siteUrl}/sitemaps/{feedpath}
Esta automatización previene situaciones en las que nuevos sitemaps generados dinámicamente tras una migración o reestructuración de catálogo queden sin notificar en Search Console.
Cuotas, límites de tasa y resolución de errores comunes
El uso de la API exige gestionar adecuadamente las restricciones impuestas por la infraestructura de Google para asegurar ejecuciones continuas sin bloqueos.
Manejo de errores 403 (Permisos insuficientes) y 429 (Límite de cuota alcanzado)
Los códigos de estado HTTP más comunes al interactuar con la API son:
1. Error HTTP 403 Forbidden (User does not have sufficient permission for site)
- Causa: La cuenta de usuario u OAuth Service Account utilizada no tiene acceso asignado a la propiedad de Search Console.
- Solución: Entra en el panel de Search Console, ve a Ajustes > Usuarios y permisos, y añade la dirección de correo electrónico del cliente OAuth o Service Account como Usuario completo o Propietario.
2. Error HTTP 429 Too Many Requests (Quota Exceeded)
- Causa: Se ha superado el número máximo de peticiones por minuto o por día asignado al proyecto en Google Cloud.
- Límites estándar:
- Peticiones por sitio: 1.200 consultas por minuto (QPM).
- Peticiones por proyecto de GCP: 1.200 QPM.
- URL Inspection API: 2.000 consultas diarias totales por propiedad (o 600 consultas por minuto).
- Solución: Implementar algoritmos de reintento con tiempo de espera exponencial (Exponential Backoff con jitter randomizado).
      import time
import random

def call_api_with_backoff(api_call, max_retries=5):
    for attempt in range(max_retries):
        try:
            return api_call()
        except Exception as e:
            if "429" in str(e) or "quota" in str(e).lower():
                sleep_time = (2 ** attempt) + random.uniform(0, 1)
                print(f"Cuota alcanzada. Reintentando en {sleep_time:.2f} segundos...")
                time.sleep(sleep_time)
            else:
                raise e
    raise Exception("Número máximo de reintentos alcanzado.")
Discrepancias de datos entre la API y la interfaz gráfica de Search Console
Es frecuente observar diferencias numéricas entre los datos extraídos por la API y los que se muestran en el panel web de Search Console. Estas variaciones se deben a tres factores técnicos:
- Umbral de privacidad (Anonymized Queries): Para proteger la privacidad de los usuarios, Google omite las búsquedas realizadas por muy pocas personas o que contienen información personal identifcable. La API omite estas filas en la dimensión
query, aunque sus clics e impresiones sí se contabilizan en los totales agregados del sitio. - Métodos de agregación: Si no se especifica
aggregationType: "byPage", la API procesa agregaciones globales por propiedad que omiten URLs específicas cuando se analiza el rendimiento granular. - Latencia de actualización (Data Lag): La API y la interfaz pueden procesar los datos de los últimos 2-3 días con ligeros descalces de tiempo según la zona horaria definida en la petición.
Cómo aprovechar Google Search Console para SEO técnico y analítico
Extraer volúmenes masivos de datos solo genera valor cuando la información se canaliza hacia auditorías de rendimiento y optimización estratégica. El uso sistemático de google search console para seo permite aislar ineficiencias en el contenido existente y detectar vectores de crecimiento orgánico sin necesidad de realizar suposiciones sobre el tráfico real.
Integrar estos datos en tu estrategia de contenidos SEO ayuda a tomar decisiones de priorización fundamentadas en datos reales de búsqueda e intención de los usuarios.
Identificación de palabras clave en posición de oportunidad (posiciones 4 a 15)
Las palabras clave en posición de oportunidad (striking distance) son aquellas términos que ya generan un volumen significativo de impresiones pero cuya posición media se encuentra relegada a la parte baja de la primera página o el inicio de la segunda (posiciones entre 4.0 y 15.0).
Algoritmo de extracción en Python:
      # Asumiendo 'df' como el DataFrame extraído previamente con dimensiones ['query', 'page']
oportunidades = df[
    (df['position'] >= 4.0) &
    (df['position'] <= 15.0) &
    (df['impressions'] >= 500)
].sort_values(by='impressions', ascending=False)

print("Oportunidades de optimización prioritarias:")
print(oportunidades[['query', 'page', 'impressions', 'position', 'ctr']].head(20))
Estas URLs son los candidatos idóneos para optimizaciones rápidas de On-Page SEO: actualización de encabezados (H2/H3), optimización de títulos (<title>) para elevar el CTR, enriquecimiento del cuerpo de texto con términos semánticos faltantes e inyección de enlaces internos directos desde páginas con mayor autoridad.
Detección de canibalizaciones y contenidos en declive (Content Decay)
1. Detección de Canibalización
Existe canibalización cuando múltiples URLs de una misma propiedad compiten en los resultados de búsqueda por la misma consulta exacta, dividiendo la autoridad del sitio y confundiendo los algoritmos de indexación de Google.
A través de la API, podemos agrupar el conjunto de datos por la dimensión query y contar el número de valores únicos en la dimensión page:
      canibalizaciones = df.groupby('query').filter(lambda x: x['page'].nunique() > 1)
query_summary = canibalizaciones.groupby('query').agg(
    urls_afectadas=('page', 'unique'),
    total_clics=('clicks', 'sum'),
    total_impresiones=('impressions', 'sum')
).reset_index()

print("Consultas con canibalización activa:")
print(query_summary.sort_values(by='total_impresiones', ascending=False))
2. Detección de Decaimiento de Contenido (Content Decay)
Comparando dos periodos temporales equivalentes mediante peticiones consecutivas a la API (por ejemplo, los últimos 90 días frente a los 90 días anteriores), podemos aislar las URLs que han perdido más del 20% de sus clics u impresiones orgánicas. Esto identifica contenidos desactualizados o desplazados por nuevos competidores.
Matriz de decisión: recurso API, dimensiones y acción SEO recomendada
La siguiente matriz conecta los recursos técnicos de la API con los casos de uso de optimización SEO dentro de un flujo operativo:
| Objetivo SEO | Recurso API | Dimensiones / Filtros | Métrica / Criterio Clave | Acción SEO Recomendada |
|---|---|---|---|---|
| Optimización CTR | searchanalytics | ["query", "page"] | Impresiones altas + CTR inferior a la media del nicho | Reescribir etiquetas <title> y meta description. Agregar marcadores de datos estructurados. |
| Páginas en declive | searchanalytics | ["page", "date"] | Pérdida sostenida de impresiones (>20% YoY o QoQ) | Audit y actualización de contenido (Content Refresh), mejora de intención de búsqueda y enlaces internos. |
| Resolución Canibalización | searchanalytics | ["query", "page"] | 2+ URLs captando impresiones para la misma intencionalidad | Aplicar redirecciones 301, consolidar contenidos o reorientar etiquetas canónicas y enlaces. |
| Auditoría de Indexación | urlInspection | N/A (URL individual) | coverageState != INDEXED o googleCanonical != userCanonical | Corregir directivas noindex, ajustar fragmentos duplicate content o corregir enlaces canónicos. |
| Limpieza de rastreo | sitemaps | N/A (Recurso Sitemap) | Errores en sitemaps o URLs obsoletas incluidas | Eliminar sitemaps antiguos, purgar URLs 404/301 e incluir únicamente URLs indexables de estado 200 OK. |
Del dato a la estrategia: Automatización del flujo de trabajo con Dango
Extraer millones de filas de datos mediante scripts en Python o cURL representa solo la primera fase de la cadena de valor. El cuello de botella principal de los equipos de SEO y marketing reside en transformar estas hojas de cálculo masivas en hojas de ruta de contenido estructuradas y ejecutables.
Para convertir estas consultas en un plan editorial eficiente, es necesario contar con un proceso sólido de investigación de palabras clave que categorice las intenciones de búsqueda y dirija los recursos de redacción hacia las oportunidades de mayor impacto.
Transformación de exportaciones masivas en grupos temáticos y briefs de contenido
Una vez extraídas miles de palabras clave mediante la Search Analytics API, el tratamiento manual fila por fila resulta inasumible. Es aquí donde entra en juego la metodología de keyword clustering , agrupando términos de búsqueda en clústeres semánticos basados en la coincidencia de intenciones y fragmentos de los SERPs.
El flujo integral de trabajo desde los datos brutos de la API hasta la publicación en el sitio web incluye los siguientes pasos:
- Conexión e Ingesta de Datos: En lugar de mantener scripts complejos de Python y gestionar límites de cuotas manualmente, plataformas avanzadas como Dango se conectan directamente con la Google Search Console API mediante una integración en un clic. Esto sincroniza automáticamente métricas de rendimiento, sitemaps y datos de rendimiento histórico.
- Clusterización Semántica y Priorización: Dango agrupa automáticamente miles de consultas en clústeres temáticos orientados a la intención del usuario. Identifica las oportunidades de alta impresión en posiciones 4-15 y detecta canibalizaciones sin necesidad de programar scripts adicionales.
- Generación de Briefs Editoriales: A partir de las oportunidades identificadas, la plataforma estructura briefs de contenido contextualizados. Integra conceptos clave de SEO semántico para garantizar que las páginas optimizadas o los nuevos artículos cubran la totalidad de la entidad temática.
- Redacción y Publicación Automatizada: El flujo se completa con la generación de artículos optimizados y su sincronización directa con el CMS (mediante integración con WordPress), cerrando la brecha entre la analítica de Search Console y la ejecución editorial.
Para aquellos equipos que buscan escalar su estrategia SEO eliminando la carga técnica de mantener sistemas propios de extracción y análisis, Dango ofrece planes profesionales (como el plan Starter por $99/mes o el plan Professional por $299/mes) que integran todo este pipeline de trabajo desde el dato bruto de Search Console hasta la publicación final.
Empieza ya a transformar los datos de Google Search Console en estrategias de contenido ejecutables.
Preguntas frecuentes sobre la Google Search Console API
¿Cuál es el límite máximo de filas que puedo obtener en una sola consulta de la Search Analytics API?
El límite máximo que se puede solicitar en el parámetro rowLimit de una sola petición HTTP a la Search Analytics API es de 25.000 filas. Sin embargo, es posible obtener la totalidad del conjunto de datos de un sitio web implementando un bucle de paginación que incremente el valor de startRow (por ejemplo, startRow: 0, startRow: 25000, startRow: 50000) en sucesivas peticiones hasta que el array de respuesta devuelva cero filas.
¿Por qué difieren los datos de la API con los que veo en el panel de Search Console?
Las discrepancias se deben principalmente a tres razones:
- Anonimización de consultas: La API no devuelve términos de búsqueda de bajo volumen para proteger la privacidad de los usuarios, reduciendo el total de filas devueltas en la dimensión
query. - Tipo de agregación: La interfaz web aplica filtros visuales automáticos, mientras que la API permite definir explícitamente si se agrupa por página (
byPage) o por propiedad (byProperty). - Zona horaria: La API procesa las fechas en formato estricto UTC o según el huso determinado en las consultas, lo que puede causar pequeños desfases de 24 horas con los gráficos visuales.
¿Qué diferencias existen entre la URL Inspection API y el informe de inspección manual?
La URL Inspection API está optimizada para la verificación volumétrica y devuelve estructuras JSON procesables con datos técnicos fundamentales (estado de cobertura, canónica declarada por el usuario, canónica elegida por Google y fecha de rastreo). A diferencia de la herramienta de inspección manual del panel web, la API no permite solicitar la indexación directa de una URL ni ejecutar pruebas en tiempo real (Live Test) renderizando el DOM o capturando capturas de pantalla del rastreador.
¿Qué nivel de permisos necesito en la propiedad para consultar la API exitosamente?
Para consultar métricas de rendimiento en la Search Analytics API, la cuenta de usuario o la Cuenta de Servicio (Service Account) asociada a las credenciales debe estar registrada en Search Console con permisos de Usuario Completo (Full User) o Propietario (Owner). Los usuarios con permisos restringidos pueden experimentar errores de autorización HTTP 403.
¿Con qué frecuencia se actualizan los datos devueltos por la Google Search Console API?
Los datos de rendimiento en Search Analytics suelen presentar un retraso o latencia de 2 a 3 días respecto al momento actual para garantizar la consolidación de las métricas. Aunque Google ofrece datos “frescos” (Fresh Data) de las últimas 24 horas en la interfaz web para algunas propiedades, la API consolida de manera más estable los datos procesados completos.
¿Cómo puedo evitar el bloqueo por cuotas al realizar consultas masivas en grandes sitios web?
Para evitar errores HTTP 429 (Quota Exceeded), debes:
- Respetar el límite de 1.200 peticiones por minuto por sitio.
- Implementar un algoritmo de reintento con retroceso exponencial (Exponential Backoff) en tu código para pausar las peticiones de forma progresiva cuando se detecte una saturación de cuota.
- Agrupar las consultas por rangos de fechas o dimensiones consolidadas en lugar de realizar cientos de llamadas de grano fino en paralelo.