Aparacer recomendado en ChatGPT se ha convertido en una de las prioridades más buscadas por los equipos de marketing y consultores SEO. Sin embargo, abordar el problema intentando entender cómo posicionarse en ChatGPT desde el prisma del SEO tradicional produce frustración rápida: en los motores de respuesta basados en inteligencia artificial no existe una lista estática de diez resultados azules ni una “posición 1” fija a la que aferrarse.
Las respuestas generadas por ChatGPT varían en función de la intención implícita de la consulta, la temperatura del modelo, el motor de búsqueda subyacente que consulte en tiempo real y la arquitectura de Recuperación Aumentada por Generación (RAG, por sus siglas en inglés).
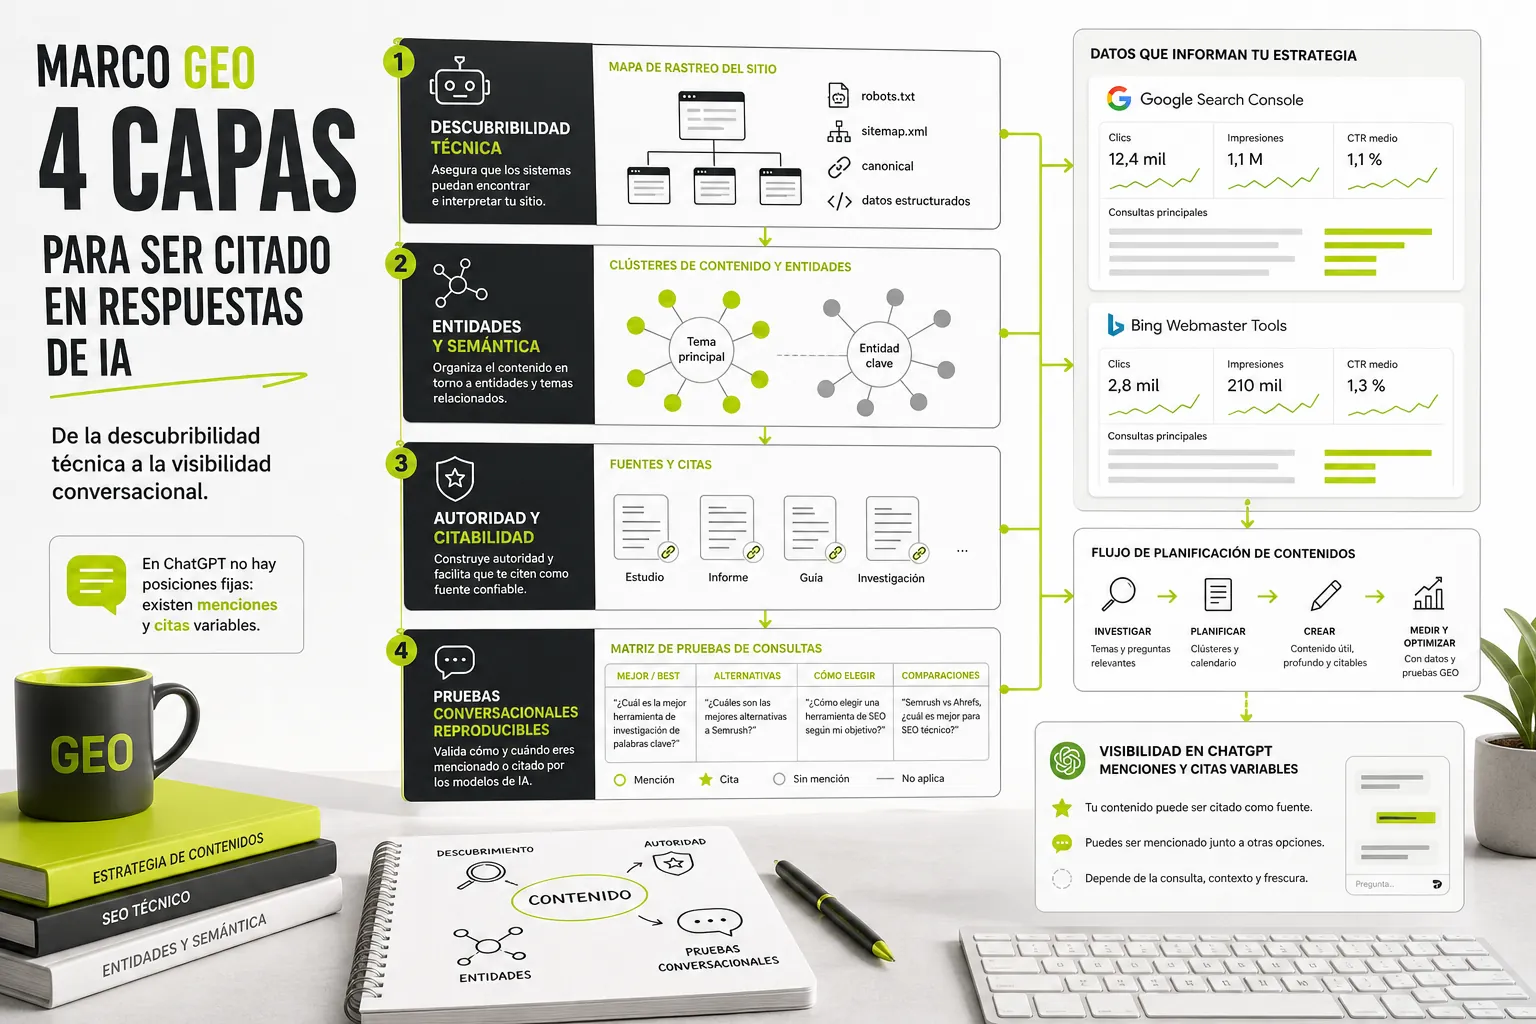
Para construir visibilidad en este nuevo entorno —disciplina frecuentemente denominada Generative Engine Optimization (GEO)— es necesario alejarse de los mitos y ejecutar una estrategia basada en evidencias concretas. En esta guía desglosamos un marco de trabajo de cuatro capas: descubribilidad técnica, claridad semántica y de entidades, autoridad de marca y metodología de pruebas reproducibles.
Qué significa posicionarse en ChatGPT y cómo funciona la visibilidad en IA
Estar presente en ChatGPT no consiste en manipular un algoritmo de ordenación tradicional. Consiste en conseguir que la información de tu sitio web sea recuperada, sintetizada y citada cuando el modelo responde a las preguntas de los usuarios.
Diferencias entre entrenamiento de modelos, rastreo web, recuperación y citación
Para entender la visibilidad en LLMs (Modelos de Lenguaje de Gran Escala), primero debemos separar cuatro procesos independientes que a menudo se confunden:
- Entrenamiento del modelo (Pre-training): Es el proceso mediante el cual el modelo absorbe volúmenes masivos de datos para aprender patrones lingüísticos, conceptos y relaciones. Los datos consumidos en esta fase tienen una fecha de corte (knowledge cutoff) y no garantizan la cita explícita de la fuente original.
- Rastreo web (Web Crawling): Crawlers específicos recorren la web de forma continua o bajo demanda. OpenAI utiliza robots como
GPTBot(para recopilar datos de entrenamiento) yOAI-SearchBot(para búsquedas conversacionales en tiempo real). - Recuperación (Retrieval / RAG): Cuando un usuario realiza una consulta que requiere información actualizada o verificable, ChatGPT ejecuta una búsqueda web externa (principalmente apoyada en índices de búsqueda como el de Bing o fuentes web en vivo). De esa búsqueda extrae pasajes o “fragmentos de texto” relevantes.
- Sintetización y citación (Generation & Citation): El modelo procesa los fragmentos recuperados, redacta la respuesta final en lenguaje natural e inserta enlaces directos o referencias hacia los dominios que aportaron los datos más coherentes y precisos.
El flujo comienza con la consulta del usuario y su clasificación de intención. Si requiere datos web, se consulta un índice o buscador, se extraen pasajes mediante RAG y se genera una respuesta con enlaces de cita. Si no requiere datos web, se utiliza el conocimiento interno paramétrico antes de generar la respuesta.
ChatGPT Search frente a Google AI Overviews, Perplexity, Gemini y Claude
Cada motor generativo opera bajo arquitecturas y fuentes de datos distintas. Comprender sus diferencias evita aplicar recetas universales que no funcionan igual en todos los sistemas:
| Plataforma | Motor de búsqueda subyacente | Tipo de citación | Enfoque principal |
|---|---|---|---|
| ChatGPT Search | Bing + Índice propio / Scraping directo | Enlaces intercalados en texto y tarjetas laterales | Búsqueda conversacional activa y síntesis directa |
| Google AI Overviews | Índice de Google Search | Enlaces integrados y carruseles superiores | Respuestas rápidas integradas en SERP tradicional |
| Perplexity | Multi-motor (Bing, Google, índice propio) | Citas numeradas con pie de página detallado | Motor de investigación con transparencia de fuentes |
| Gemini | Índice de Google + Knowledge Graph | Tarjetas de fuentes y enlaces desplegables | Integración profunda con el ecosistema Google |
| Claude | Sin motor de búsqueda web por defecto en API estándar | No cita enlaces web externos por defecto | Razonamiento analítico y procesamiento de contexto extenso |
Capa 1: Descubribilidad técnica y controles de rastreo
La primera condición para que ChatGPT pueda citar tu contenido cuando realiza búsquedas en vivo es que sus bots tengan acceso técnico sin restricciones a tus páginas.
El rol real de GPTBot y OAI-SearchBot en el archivo robots.txt
Muchos administradores web bloquearon GPTBot por temor al uso de sus contenidos para el entrenamiento de IA. Sin embargo, es crítico diferenciar la función de los dos user-agents principales de OpenAI:
-
GPTBot: Utilizado para recopilar datos que entrenan las futuras versiones de los modelos. Bloquearlo impide que tu sitio alimente la memoria base del modelo, pero no bloquea necesariamente las búsquedas web en tiempo real de ChatGPT Search. -
OAI-SearchBot: Utilizado específicamente para el rastreo y recuperación de información cuando los usuarios realizan consultas en ChatGPT Search. Si bloqueas este bot en turobots.txt, ChatGPT no podrá rastrear tu contenido para responder a consultas vivas y tu marca desaparecerá de las citas en tiempo real.
Una configuración recomendada en el archivo robots.txt para permitir la visibilidad en búsquedas conversacionales sin ceder material masivo de entrenamiento es:
      User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Requisitos técnicos de rastreabilidad: JavaScript, URLs canónicas y estados HTTP
Los agentes de recuperación de información priorizan la velocidad y el bajo coste de computación. Por tanto:
- Renderizado de JavaScript: Aunque los motores modernos ejecutan JS, los bots de búsqueda rápida prefieren contenido renderizado en el servidor (SSR) o HTML estático. Si tu contenido clave depende de hidrataciones complejas de JavaScript en el cliente, corres el riesgo de que el crawler extraiga un documento vacío.
- URLs Canónicas e indexabilidad: Asegúrate de que las páginas devuelvan un código de estado
200 OKlimpio. Las URLs con directivasnoindex, redirecciones en cadena o etiquetascanonicalapuntando a otras direcciones serán descartadas durante la fase de selección de pasajes.
Google Search Console y Bing Webmaster Tools como base de diagnóstico
Dado que ChatGPT Search apoya gran parte de su descubrimiento web en la infraestructura y el índice de Bing, monitorear la salud de tu sitio en Bing Webmaster Tools es una prioridad técnica inmediata. Verifica que tu sitemap XML esté procesado sin errores y que las páginas estratégicas estén indexadas por Bing.
Por otro lado, los datos de rendimiento orgánico tradicional sirven para identificar las consultas exactas donde tu audiencia busca soluciones. Para automatizar este análisis y cruzar datos masivos de rendimiento, puedes utilizar la Google Search Console API , lo que permite extraer patrones de demanda, detectar caídas de indexación y diagnosticar qué URLs reciben tráfico orgánico real.
Límites de IndexNow y el estado actual de la especificación llms.txt
Existe la falsa creencia de que implementar protocolos como IndexNow o crear un archivo llms.txt garantiza aparecer en las respuestas de ChatGPT. Analicemos su realidad técnica:
- IndexNow: Es un protocolo excelente para notificar instantáneamente a Bing y Yandex sobre cambios o nuevos contenidos en tu web. Acelera el rastreo técnico por parte de Bing, pero no otorga ninguna ventaja algorítmica ni asegura que el LLM elija tu pasaje sobre el de un competidor.
- Especificación
llms.txt: Se trata de una propuesta experimental de la comunidad para ofrecer un archivo ejecutable en Markdown con resúmenes simplificados de un sitio web. Aunque facilita la lectura a scripts o herramientas que consumen context windows, no es un estándar oficial adoptado formalmente por OpenAI para ponderar ni garantizar citaciones en ChatGPT Search. Debe tratarse como una práctica experimental opcional, jamás como una palanca primaria de posicionamiento.
Capa 2: Claridad semántica, entidades y optimización de contenido
Cuando el motor de búsqueda de ChatGPT recupera diez o veinte páginas web para responder a una pregunta, el LLM analiza el texto plano de esos documentos. Las páginas mejor estructuradas y con mayor densidad conceptual tienen una probabilidad significativamente superior de ser seleccionadas.
Estructura answer-first: definiciones directas, tablas y pasajes concisos
Los LLMs evalúan la relevancia fragmento a fragmento (passage-level retrieval). Para facilitar la extracción de datos por parte de la IA, aplica una arquitectura de contenidos del tipo “pirámide invertida”:
- Definiciones directas al inicio (Answer-First): Comienza las secciones respondiendo a la pregunta principal en las primeras 20-40 palabras de forma clara y sin rodeos.
- Listas y tablas comparativas: Las tablas HTML bien etiquetadas (
<table>,<th>,<td>) son leídas con extrema precisión por los algoritmos de extracción. Facilitan la comparación directa de atributos. - Encabezados explicativos: Utiliza etiquetas
##y###en forma de preguntas explícitas o afirmaciones directas que coincidan con la intención de búsqueda conversacional.
Coherencia de entidad de marca, marcado JSON-LD y HTML semántico
Para que un modelo de lenguaje entienda qué es tu marca, qué productos vende y por qué es una autoridad en un sector, necesita identificar tu entidad en su mapa de conocimiento.
Para profundizar en la construcción de grafos de conocimiento y relaciones conceptuales, resulta imprescindible dominar las bases de entidades y SEO semántico , lo que permite estructurar la información de un dominio de forma que los motores de búsqueda e IA comprendan el contexto exacto de cada término.
A nivel práctico, esto exige:
- Marcado JSON-LD preciso: Implementa esquemas de
Organization,Product,ArticleyAuthorvinculando propiedades clave comosameAshacia perfiles oficiales, entradas de Wikipedia, Wikidata o registros corporativos. - HTML semántico: Usa etiquetas nativas (
<article>,<section>,<aside>,<header>) en lugar de estructuras compuestas exclusivamente por<div>anidados sin significado.
      {
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Nombre de tu Empresa",
  "url": "https://tusitio.com",
  "sameAs": [
    "https://www.wikidata.org/wiki/QXXXXXX",
    "https://www.linkedin.com/company/tuempresa"
  ]
}
Formatos de contenido para intenciones conversacionales: guías, comparativas y alternativas
Los usuarios no le preguntan a ChatGPT utilizando palabras clave sueltas como “comprar software crm”. Hacen preguntas complejas y contextuales. Tu arquitectura de contenidos debe cubrir explícitamente estos formatos:
- Consultas de recomendación (“Los mejores X para Y”): Páginas que listan soluciones especificando pros, contras, casos de uso ideales y rangos de precio explícitos.
- Consultas de comparación (“A frente a B”): Páginas que enfrentan dos alternativas bajo criterios homogéneos de evaluación.
- Consultas de alternativas (“Alternativas a X”): Contenidos enfocados en sustitutos, destacando diferencias operativas y de coste.
- Guías de decisión (“Cómo elegir X”): Pasos metodológicos claros con criterios de selección cuantitativos.
Capa 3: Autoridad temática, fuentes citables y reputación
Un modelo de lenguaje genera respuestas basadas en la probabilidad de que una afirmación sea correcta. Para minimizar las alucinaciones, los algoritmos de RAG favorecen fuentes que muestran alta consistencia temática y respaldo de terceros.
Consolidación de autoridad temática mediante clusters de contenido y enlazado interno
Un sitio web con artículos aislados difícilmente será percibido como una autoridad sobre un tema complejo. La forma más efectiva de demostrar conocimiento profundo a los motores de búsqueda es la creación de clusters temáticos.
Agrupar páginas interconectadas mediante hipervínculos contextuales demuestra amplitud y profundidad de cobertura. Para diseñar esta estructura de manera sistemática, conviene organizar tus temas utilizando keyword clusters por intención , consolidando páginas pilar y artículos de soporte que refuercen la relevancia temática global del dominio.
Una página pilar sobre la guía principal se enlaza con subtemas técnicos, casos y comparativas. Estos subtemas también se conectan entre sí mediante enlazado interno cruzado.
Menciones de terceros, reseñas y citas externas: correlación frente a causalidad
Aparecer recomendado en ChatGPT no depende únicamente de lo que publicas en tu propio sitio web. Durante el proceso de búsqueda en vivo, el modelo contrasta la información con fuentes externas.
- Menciones de marca de terceros: Apariciones en medios del sector, blogs independientes, directorios especializados y foros de discusión (como Reddit o Quora) crean una coocurrencia semántica entre tu marca y tu categoría de negocio.
- Reseñas y valoraciones: Las opiniones consolidadas en plataformas externas influyen directamente cuando el modelo responde a consultas del tipo “¿Qué tan confiable es el servicio X?”.
- Causalidad vs. Correlación: Es vital entender que no existe una métrica oficial de “PageRank para ChatGPT”. Una mención externa no transmite “link juice” en el sentido clásico del SEO; lo que transmite es confirmación conceptual. Cuantas más fuentes independientes afirmen que tu marca ofrece la mejor solución para un problema, mayor será la probabilidad estadística de que el LLM incluya esa afirmación en su respuesta.
Capa 4: Metodología para medir y monitorizar la presencia en ChatGPT
No se puede optimizar lo que no se mide. Como ChatGPT genera respuestas estocásticas (variables), es necesario adoptar una metodología rigurosa para evaluar si tus acciones aumentan la visibilidad de tu marca.
Matriz de pruebas con prompts fijos y control de variables
Para realizar un seguimiento fiable, crea un panel de control con un conjunto cerrado de prompts representativos de tu negocio. Para evitar sesgos en las mediciones, mantén constantes las siguientes variables durante las pruebas:
- Estado de sesión: Utiliza siempre ventanas de incógnito o cuentas de prueba estandarizadas.
- Uso de Web Search: Especifica si la prueba se realiza con la búsqueda web activada o desactivada.
- Ubicación geográfica e idioma: Documenta la IP y la configuración regional desde la que realizas la consulta.
- Modelo probado: Registra la versión exacta del modelo (ej. ChatGPT-4o, ChatGPT Search).
Ejemplo de Matriz de Pruebas GEO:
| Prompt de prueba | Intención | Marca citada (Sí/No) | Posición / Orden de mención | Dominio citado como fuente | Notas del contexto |
|---|---|---|---|---|---|
| ”Cuáles son los mejores software para X” | Recomendación | Sí | 2ª opción | tusitio.com/blog/comparativa | Citado junto a dos competidores |
| ”Alternativas a [Competidor]“ | Sustitución | No | N/A | blogtercero.com | El modelo citó una reseña externa |
| ”Cómo resolver [Problema técnico]“ | Informativa | Sí | Fuente principal | tusitio.com/guias/solucion | Cita con enlace directo en el texto |
Registro de menciones, cuota de fuentes citadas y seguimiento de cambios
A partir de tu matriz de pruebas, calcula mensualmente tres métricas clave:
- Share of Model (Cuota de Mención de Marca): Porcentaje de prompts de la muestra en los que tu marca es nombrada explícitamente en la respuesta.
- Share of Citations (Cuota de Fuentes Citadas): Porcentaje de prompts en los que una URL de tu dominio aparece como enlace de referencia o tarjeta de fuente.
- Precisión del contexto: Evaluación cualitativa de si la descripción que hace el modelo sobre tu producto o servicio es objetivamente correcta o contiene imprecisiones.
Errores comunes y limitaciones en la atribución de tráfico de IA
El afán por capturar tráfico desde motores conversacionales ha llevado a muchos equipos a cometer errores de estrategia y diagnóstico.
Por qué los Featured Snippets de Google no garantizan aparecer en ChatGPT
Un error frecuente es asumir que dominar los Featured Snippets o la posición 1 en Google garantiza la presencia automática en las respuestas de ChatGPT.
Aunque ambos sistemas buscan responder preguntas de forma directa, utilizan mecanismos de selección radicalmente distintos:
- Google Featured Snippets: Selecciona un pasaje casi textual de una página web basándose en algoritmos de clasificación de búsqueda tradicionales y señales de relevancia del índice de Google.
- ChatGPT Search: Extrae múltiples pasajes de diferentes fuentes (apoyándose en gran medida en el índice de Bing y rascado en vivo), condensa la información mediante un modelo de lenguaje y redacta una respuesta sintética original. Estar en el snippet de Google no implica que el agente de búsqueda de OpenAI elija tu web en sus resultados de Bing.
Dificultades y sesgos al intentar medir el tráfico de IA en Google Analytics
Medir el tráfico web proveniente de ChatGPT dentro de herramientas como Google Analytics 4 (GA4) presenta serias limitaciones técnicas:
- Pérdida de Referrer: Gran parte de las interacciones en ChatGPT ocurren en aplicaciones móviles nativas o de escritorio donde las referencias HTTP se pierden, registrando las visitas como tráfico
Direct(Directo). - Encabezados cambiantes: El tráfico web referido desde la versión de escritorio de ChatGPT suele registrarse bajo el dominio
chatgpt.comoreferral / chatgpt.com, pero las integraciones en navegadores o barras laterales pueden reportarse de forma inconsistente. - Bajo volumen de clics directos (Zero-Click Searches): Muchos usuarios obtienen la respuesta completa dentro del chat y jamás hacen clic en las fuentes citadas. Por ello, el impacto real de la IA suele reflejarse más en un incremento del tráfico directo y búsquedas de marca, que en un volumen masivo de referidos en Analytics.
Checklist de implementación y plan de trabajo
Para ejecutar esta estrategia sin dispersar recursos, aplica esta matriz de priorización dividida por nivel de evidencia científica, impacto esperado y esfuerzo técnico.
Matriz de priorización según impacto, evidencia y esfuerzo
| Capa | Acción de implementación | Evidencia | Impacto | Esfuerzo |
|---|---|---|---|---|
| Técnica | Permitir OAI-SearchBot en robots.txt | Demostrada | Crítico | Muy bajo |
| Técnica | Asegurar renderizado servidor (SSR) e indexación en Bing | Demostrada | Alto | Medio |
| Contenido | Estructurar párrafos Answer-First y tablas HTML | Demostrada | Alto | Bajo |
| Entidades | Implementar Schema.org (Organization, Article) con sameAs | Demostrada | Medio | Bajo |
| Autoridad | Desarrollar clusters de contenido interconectados | Demostrada | Alto | Medio |
| Autoridad | Digital PR para conseguir menciones en medios del sector | Correlacional | Medio | Alto |
| Medición | Crear matriz de pruebas con prompts fijos | Demostrada | Alto | Bajo |
| Experimental | Crear archivo llms.txt | No probada / Hipótesis | Incierto | Muy bajo |
Cómo organizar clusters de contenido desde datos de Search Console con Dango
Para construir la capa de claridad semántica y autoridad temática descrita en esta guía, el primer paso práctico no es redactar al azar, sino identificar qué necesidades reales de información está demandando tu audiencia en los buscadores.
En Dango aplicamos un flujo de trabajo estructurado que conecta los datos reales de búsqueda de tu sitio con la planificación de contenidos listos para responder a consultas complejas:
El flujo parte de datos reales de GSC, continúa con el clustering por intención y la creación de briefs estructurados, y termina con artículos Answer-First.
- Conexión de datos reales: Al conectar Google Search Console y tu sitemap, identificas las consultas reales donde tu sitio ya tiene tracción o detectas brechas de contenido no cubiertas.
- Agrupación en clusters temáticos: Las palabras clave se agrupan por intención de búsqueda. Esto permite diseñar una página pilar y sus respectivos artículos de soporte, evitando la canibalización.
- Generación de briefs estructurados: Se generan escaletas con arquitectura answer-first, asegurando que el contenido incluya definiciones claras, secciones de preguntas y tablas listas para ser interpretadas por crawlers y LLMs.
- Redacción asistida e integración: Creación de borradores optimizados e integración directa con gestores de contenido como WordPress.
Si buscas escalar tu estrategia de contenidos sobre una base de datos real, puedes explorar la plataforma SEO con IA de Dango . Con planes disponibles a partir de 99 /mes para la opción Professional, dispones de una suite diseñada para transformar datos de Search Console en clusters temáticos y contenidos perfectamente estructurados. Si este flujo de trabajo encaja con las necesidades de tu equipo, visita su web y empieza ya a optimizar la autoridad temática de tu dominio.
Preguntas frecuentes sobre cómo posicionarse en ChatGPT
¿Es posible garantizar el primer lugar en las respuestas de ChatGPT?
No, es imposible garantizar una posición fija. ChatGPT genera respuestas dinámicas y probabilísticas que cambian según el contexto de la conversación, la ubicación del usuario, el modelo seleccionado y la búsqueda web realizada en tiempo real. La estrategia GEO busca maximizar la probabilidad de ser citado, no comprar una posición estática.
¿Cómo influye el archivo llms.txt en la visibilidad dentro de ChatGPT?
Actualmente, el archivo llms.txt es una propuesta experimental de la comunidad y no un estándar oficialmente adoptado por OpenAI. Aunque ayuda a sintetizar la información de un sitio para herramientas que leen texto estático, no garantiza la indexación, el rastreo ni la citación prioritaria dentro de ChatGPT Search.
¿Cuál es la diferencia entre el SEO tradicional y el posicionamiento en ChatGPT?
El SEO tradicional optimiza páginas para que coincidan con palabras clave y escalen en un índice ordenado de enlaces (SERP). El posicionamiento en ChatGPT (GEO) optimiza la claridad conceptual, las entidades y la estructura de los pasajes para que un modelo de lenguaje pueda recuperar, comprender y sintetizar la información dentro de una respuesta conversacional.
¿Sirve de algo registrar la web en Bing Webmaster Tools para aparecer en ChatGPT?
Sí, es muy recomendable. ChatGPT Search utiliza principalmente el índice de búsqueda de Bing para recuperar información de la web en tiempo real. Verificar que tu dominio está correctamente indexado y sin errores de rastreo en Bing Webmaster Tools es un paso técnico fundamental.
¿Cómo se puede medir si ChatGPT está recomendando una marca?
Dado que no existen herramientas analíticas oficiales de OpenAI para sitios web, la medición debe hacerse mediante una matriz de pruebas con un conjunto fijo de prompts conversacionales. Registrando periódicamente las respuestas en condiciones controladas, es posible medir el Share of Model (cuota de menciones de marca) y el Share of Citations (cuota de enlaces recibidos).
¿Aparecer en los Featured Snippets de Google asegura ser citado por ChatGPT?
No. Google y ChatGPT utilizan motores de búsqueda, índices y algoritmos de procesamiento del lenguaje completamente independientes. Aunque ambos premian las respuestas directas y bien estructuradas, tener un Featured Snippet en Google no implica que el sistema de recuperación de ChatGPT vaya a seleccionar esa misma fuente.